Im Rennen um effiziente KI-Rechenzentren setzt Qualcomm auf eine eigene Speicherarchitektur. Wie ComputerBase und ServeTheHome berichten, hat das Unternehmen die erste Validierung seiner Technik High Bandwidth Compute, kurz HBC, abgeschlossen. Sie soll in den kommenden Dragonfly-Beschleunigern für Rechenzentren zum Einsatz kommen, deren erstes Modell AI250 im ersten Halbjahr 2027 als Muster an Kunden gehen soll.
Rechnen direkt unter dem Speicher
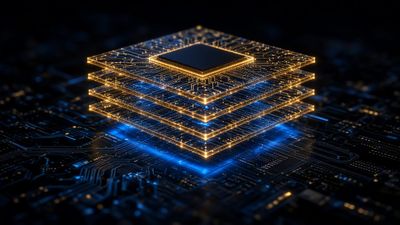
HBC besteht aus mehreren übereinander gestapelten DRAM-Lagen und einem kleinen Rechenchip direkt darunter. Beim etablierten High Bandwidth Memory (HBM) sind die Speicherstapel dagegen über eine sehr breite Schnittstelle an den Hauptprozessor angebunden. Bei HBC sollen besonders bandbreitenintensive Berechnungen direkt am Speicher stattfinden; nur die Ergebnisse gehen an den zentralen Prozessor weiter. Der Rechenchip ist dabei kein vollständiger Prozessor, sondern auf diese speichernahen Aufgaben spezialisiert.
Der Vorteil liegt in der Energie. Daten zu bewegen kostet Strom, und je weiter die Wege, desto mehr. Wenn der Speicher direkt auf dem Rechenchip sitzt, entfallen selbst die kurzen Strecken einer HBM-Anbindung. Die eingesparte Energie kann laut Qualcomm entweder in mehr Leistung fließen oder es erlauben, mehr Chips im selben Energierahmen zu betreiben. Besonders für KI-Inferenz, bei der hohe Bandbreite und große Speicherkapazität gleichzeitig gefragt sind, soll sich HBC eignen.
LPDDR5X statt HBM-Chips
Für die Stapel nutzt Qualcomm LPDDR5X-Speicher, wie er auch in Smartphones und Notebooks steckt, statt der teuren HBM-Chips. Die Kapazität eines HBC-Stapels soll über der aktueller HBM4-Implementierungen liegen; konkrete Werte für ein fertiges Produkt nennt Qualcomm noch nicht. Weil ein Teil der Arbeit bereits im Stapel erledigt wird, reicht für die Verbindung zum Hauptprozessor womöglich günstigere Technik wie herkömmliche organische Substrate. Das Stapeln selbst bleibt aber anspruchsvoll und erfordert wie bei HBM vertikale Durchkontaktierungen durch das Silizium.
Erste Messwerte
Für die Validierung testete Qualcomm einen frühen Stapel mit zwei DRAM-Lagen; Serienprodukte sollen vier Lagen erhalten. Bei der Bandbreite pro Watt erreichte HBC nach Herstellerangaben mehr als das Fünffache von HBM4 und das 18-Fache von herkömmlichem LPDDR5X. Ursprünglich hatte Qualcomm einen Faktor von sechs gegenüber HBM4 angepeilt. Die Ergebnisse liegen also nahe am Ziel, aber noch nicht ganz dort. Unabhängige Messungen gibt es bislang nicht.
Einordnung im Markt
HBM ist derzeit einer der größten Engpässe der KI-Industrie. Die Hersteller kommen mit der Produktion kaum nach, und die Preise für Speicher steigen auf breiter Front. Eine Architektur, die auf weiter verbreitetem LPDDR5X aufbaut, könnte diesen Druck mindern – sofern sie in Serie die versprochenen Werte erreicht. Qualcomm tritt mit Dragonfly gegen etablierte Anbieter an, die ihre Position im Rechenzentrum über Jahre ausgebaut haben.